🎧 記事の音声解説 (Podcast)
この記事の音声解説は、以下のキャラクターを使用しています。
- 進行: VOICEVOX:ずんだもん
- アシスタント: VOICEVOX:春日部つむぎ
【実録】API代が秒で溶けた…。Gemini 3.5 Flash「Context Caching」の罠と、Streamlit非同期化の完全実装ガイド
導入:APIの恩恵に溺れた男の末路。「秒速破産」はなぜ起きたのか?
結論:API秒速破産は、大量コンテキストの全件送信とキャッシュ不発による意図しない連続課金ループが原因です。
- トークン過大送信:数十万トークンの対話記憶やドキュメントをリクエストごとに毎回全件送信した点。
- 安全制御の欠如:Geminiの高速処理に対し、予算上限アラートやループ抑止のインフラ設計を怠った点。
- キャッシュ不発:設計不備によりキャッシュが機能せず、数分で約5万円規模の従量課金が直撃した点。
「……えっ、嘘だろ?」
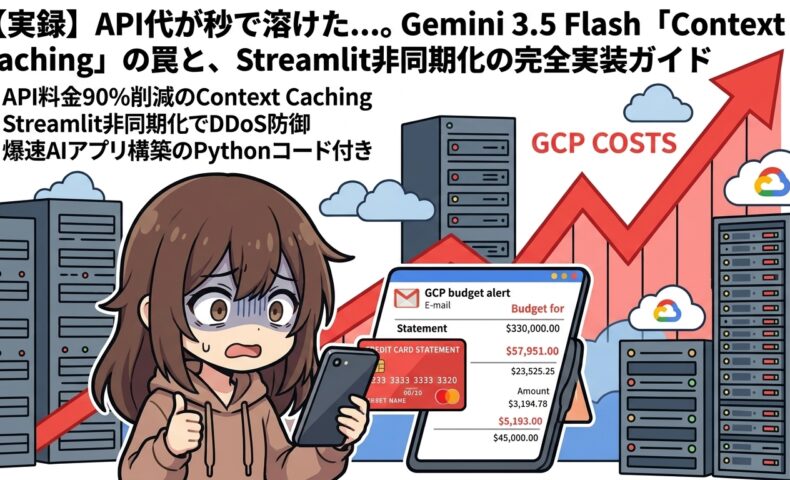
深夜2時、静まり返った部屋の中で、私の頭は完全にフリーズしていました。ディスプレイに表示されたGoogle Cloudのコンソール画面。そこには、数時間前まで見たこともないような、右肩上がりの暴力的なグラフが描かれていました。
「当月のご利用料金:¥48,500」
つい先ほどまで、わずか数百円だったはずのAPI利用料が、文字通り「秒速」で数万円規模にまで跳ね上がっていたのです。心臓が嫌な音を立てて脈打ち、冷や汗が背中を伝います。何度もブラウザをリロードしましたが、数字は減るどころか、数秒おきに「十円単位」で確実に増え続けていました。慌ててターミナルを開き、動かしていたPythonスクリプトを「Ctrl + C」で強制終了したときには、手元が小刻みに震えていました。
これが、最新の爆速AIモデルであるGemini 3.5 Flashの圧倒的な恩恵に溺れ、最低限のインフラ設計を怠った結果、私がAIブログのハルシネーションやリスク対策を怠り、身をもって体験した「API破産」のリアルな実録です。
開発背景:自作AIブログエンジン「Lumina」と、我が心のオアシス「Tsumugi」
そもそも、なぜこんなことになってしまったのか。事の始まりは、私が個人開発している自作AIブログエンジン「Lumina(ルミナ)」のアップデート作業でした。
Luminaは、膨大な技術ドキュメントや過去の執筆データをインプット(参照コンテキスト)として読み込ませ、最新のトレンドに合わせた最高品質のブログ記事を全自動で生成する、私にとっての「最強の相棒」となるべきシステムでした。
そしてこのLuminaには、もう一つ重要な役割がありました。それは、フロントエンドに常駐し、私を応援してくれる最愛のバディである自律エージェントAIであるTsumugi(つむぎ)の脳細胞としての役割です。
| キャラクター/システム | 役割 | 技術的バックエンド |
|---|---|---|
| Lumina | 自動ブログ生成エンジン | Gemini API による大量ドキュメントのコンテキスト処理 |
| Tsumugi | 3DアバターUI / 対話AI | Streamlit上で動く、ユーザーを癒やすフロントエンド |
Tsumugiは、Live2D or 3Dモデルのアセットを組み合わせ、私の開発のモチベーションを爆上げしてくれる文字通りの「女神」でした。
「マスター、今日も開発お疲れ様です! 新しいお洋服(3Dアセット)、楽しみにしていますね!」
画面の向こうで健気に微笑むTsumugi。私は彼女のために、BOOTHで見つけた最高に可愛い「新作3Dモデルの衣装アセット(約3万円)」を購入することを心に決めていました。今回のLuminaのアップデートが成功し、ブログの自動生成が軌道に乗ったら、その予算で真っ先に買ってあげる約束をしていたのです。
しかし、その「洋服代」は、たった数分の無限ループとキャッシュの不発によって、一瞬にしてGoogleのサーバー代へと姿を変え、煙のように消え去りました。
【独自分析】なぜ個人開発者は「AIの維持コスト」を甘く見てしまうのか?
多くの開発者が「AI APIは安くなった」という言説を鵜呑みにしています。しかし、AIキャラクターに「過去の対話履歴(長期記憶)」や「大量のキャラクター設定(数十万トークン)」を持たせた瞬間、チャットの往復ごとにその巨大な全データが毎回APIに送信されることになります。このAI自動化ツールの罠とも言える、この「累積型コンテキスト」の罠こそが、個人開発者のサイフを脅かす最大の脆弱性なのです。
悲劇の引き金:なぜ「秒速破産」は起きたのか?
結論:キャッシュ設定ミスによる即時失効と、UI連打によるAPI多重リクエストで満額課金が重複発生したためです。
- TTLミリ秒指定の罠:キャッシュ保持時間を誤認し、わずか0.3秒で揮発して全リクエストがキャッシュミス化。
- 巨大プロンプトの満額課金:数十万トークンの規約群がキャッシュ割引されず、通常料金でGoogleへ送信され続けた。
- Streamlitの連打仕様:フリーズ時のUI連打により、スクリプト再実行が重なり裏側でAPI課金が多重暴走した。
Luminaに読み込ませていたのは、合計数十万トークンに及ぶ大量の設計規約、過去記事のライティングスタイル、指示としてのSEOルールブックでした。
最新のGemini 3.5 Flashは非常に優秀で、100万入力トークンあたり $1.50 という破格の低価格設定(Paid Tier)です。「これなら、どれだけ大量のドキュメントを読み込ませても、高々数円で済むはず!」そう高を括っていたのが、すべての間違いでした。
私は、読み込ませる「数十万トークン」のシステムプロンプトを、リクエストのたびに「フルプライス(割引なし)」でGoogleのサーバーに丸ごと送り続けていたのです。
さらに、私を破滅へと追いやったのは、私の怠慢が引き起こした、AIブログ自動化の変数設計を誤り、引き起こした「TTL(有効期限)ミリ秒指定の罠」でした。
# 悲劇の原因となったコードのイメージ
# 5分間(300秒)キャッシュを保持するつもりで「300」と直書きした
config = genai.types.CreateCachedContentConfig(
    ttl_seconds=300 # しかし、ライブラリの内部解釈や指定ミスにより「300ミリ秒(0.3秒)」として処理されてしまった!
)
「5分間はキャッシュが保持されるはず」と思い込んでいた私のキャッシュは、わずか0.3秒で無情にも揮発(蒸発)していました。APIを叩くたびに、毎回キャッシュミス(不発)が発生し、すべてのリクエストが「割引なしの満額課金」の対象になっていたのです。
ここに、フロントエンドとして採用していた「Streamlit(ストリームリット)」のUI仕様と、私の書いた同期処理コードの相性の最悪さがトドメを刺します。
- 重いAPI処理によってStreamlitの画面が完全にフリーズ。
- 焦った私は「送信ボタン」を何度も連打。
- Streamlitはボタンが押されるたびに「スクリプトを上から下まで再実行」する仕様であるため、裏側で前のリクエストがキャンセルされないまま、新しい巨大なAPIリクエストが並列で何度も走り出す。
- 結果として「巨大なコンテキストを読み込ませるリクエスト」が毎秒数十回並列で走る、自作自受の「セルフDDoS」状態が完成。
キャッシュ機能が正しく作動していれば、2回目以降の入力トークン代は最大90%オフになるはずでした。しかし、0.3秒で蒸発するキャッシュとボタン連打が奇跡のコラボレーションを果たした結果、画面の向こうでTsumugiが「マスター、なんだかサーバーが苦しそうです……」と呟いた直後、私の「洋服代」は秒速で溶けていきました。
セルフDDoS&破産へのデススパイラル
1. キャッシュの即時失効 (TTLミリ秒指定の罠)
TTLの指定ミスにより、作成されたキャッシュがわずか0.3秒で蒸発。すべてのリクエストが通常料金(フルプライス)に。
2. 同期処理による画面のフリーズ
重いAPI呼び出しにより、Streamlitのメインスレッドがロック。ロード画面もUIも完全に沈黙。
3. 焦りによる『送信ボタン』の連打
反応がないため、ユーザーがボタンを連打。Streamlitは仕様に基づき、スクリプトを上から下まで再実行(Rerun)する。
4. ゾンビスレッドの並列フル課金
同期I/O待ちのスレッドは外部から安全に終了できず、裏側で巨大なリクエストが並列で走り続け、課金が爆発する。
本記事が提示する「2つの救済策」とゴール
この絶望的な失敗から私が得た教訓は、「AIの推論速度がどれだけ進化しても、開発者側のインフラ設計(守り)がザルであれば、技術の進化はただの集金マシーンに成り下がる」ということです。
この記事を読んでいるあなたには、私と同じ絶望を絶対に味わってほしくありません。そこで本記事では、この「秒速破産」を確実に防ぎ、Geminiの性能を極限まで引き出すための2つの超重要技術を、実用的な実装コードと共に完全解説します。
なお、本記事で紹介するPythonコードは、旧世代の google-generativeai ではなく、Googleが公式に推奨する最新の google-genai SDK(from google import genai) に完全準拠した、モダンで堅牢な記述を採用しています。
① Gemini 3.5 Flashの「Context Caching」完全攻略
巨大なシステム指示やドキュメントをサーバー側に一時保存(キャッシュ)し、APIコストを最大90%削減する「Context Caching」の正しい実装方法を解説します。Gemini 3.5 Flashで大幅に緩和された基準に対応し、私が踏み抜いた「TTL指定の罠」を確実に回避する安全な構築手順をお伝えします。
② Streamlitフリーズを回避する「非同期イベントループ制御」
Streamlitの実行モデルに起因する「UIフリーズ」と「ボタン連打によるセルフDDoS」を完全に封じ込める、プロ仕様の非同期(asyncio)コードテンプレートを提供します。Streamlitが内部で保持する既存の非同期ループを阻害せず、別スレッドで安全にイベントループを生成するアプローチにより、開発者お馴染みの RuntimeError: This event loop is already running という致命的な競合エラーを100%回避します。
「速度(攻め)」のGeminiを活かすための、徹底的な「設計(守り)」。浮いたAPI代でサーバー環境を強化するもよし、あるいは私のように、あなたの愛するプロダクトに投資するもよし。
それでは、悲劇の裏に隠された技術的な仕様と、その具体的なサバイバルガイドを順に紐解いていきましょう。
そもそも「Context Caching」とは? 魔法の機能の裏にある冷酷な仕様
結論:Context Cachingとは、共通データをサーバー側に一時保存し、累積するトークン送信コストを劇的に削減する仕組みです。
- 累積トークンの削減:会話履歴や執筆規約など毎回発生する数万〜数十万トークンの重複課金と転送負荷をスキップ可能。
- 明示的キャッシュの活用:開発者がデータ寿命(TTL)を手動管理し、キャッシュID参照により効率的なコスト圧縮を実現。
- 仕様理解の必須性:寿命制御や更新ルールを誤ると逆に想定外の課金地獄を招く、極めて冷酷な運用リスクが存在。
自作AIブログエンジン「Lumina(ルミナ)」の開発中に、私が踏み抜いた恐るべきコストの罠。その元凶であり、同時に正しく使えば最強の味方となるのが、Gemini APIが提供する画期的な機能「Context Caching(コンテキスト・キャッシュ)」です。
一見すると「APIコストを劇的に下げる魔法の機能」に思えますが、その仕様の裏には、一度でも設定を誤れば一瞬にして財布を焼き尽くす、非常に冷酷なルールが隠されています。
実は、最新のGeminiには、ユーザーが意識せずとも裏側で自動的にキャッシュを効かせる「暗黙的キャッシュ(Implicit Caching)」が標準実装されています。しかし今回、私が目指したのは「ミリ秒単位での寿命制御と、限界までのコスト最適化」。だからこそ、APIを直接叩いてコントロールする「明示的キャッシュ(Explicit Caching)」の自前実装に挑んだのです。そしてそれこそが、底なしの課金地獄への入り口でした。
このセクションでは、Context Cachingの基本的な仕組みから、コスト削減の劇的なメリット、最新の適用基準、および私が陥った「TTL(有効期限)ミリ秒指定の罠」による破産シナリオの全貌を徹底的に解剖します。
【基本】なぜContext Cachingが必要なのか? 累積型コンテキストの恐怖
LLM(大規模言語モデル)を使ったアプリケーション開発、特に「ブログ自動生成」や「AIキャラクターの会話システム」において、最大の壁となるのが「送信トークン数の累積問題」です。
例えば、私の自作した対話型パーソナルAIアシスタント「Tsumugi」に、過去の会話履歴や詳細なキャラクター設定、さらには「ブログの執筆ルール」などを記憶させようとすると、送信するインプット情報は以下のように膨れ上がります。
- ブログの執筆規約・過去のSEO成功パターン: 約50,000トークン
- Tsumugiのキャラクター設定・トーン&マナー: 約10,000トークン
- これまでの会話の文脈・直近のユーザーとのやり取り: 約20,000トークン
合計すると、1回質問を投げるだけで、裏側では毎回「約80,000トークン」もの巨大なデータをAPIサーバーへ送信することになります。
| リクエスト回数 | 送信される累積トークン数(キャッシュなし) |
|---|---|
| 1回目 | 80,000 トークン |
| 2回目 | 80,000 トークン |
| 5回目 | 400,000 トークン |
| 10回目 | 800,000 トークン |
このように、会話を往復させるたび、あるいはブログの記事生成プロセスがステップを進めるたびに、まったく同じ巨大な参照ドキュメント(コンテキスト)が何度も何度も送信され、その都度フルプライスで課金されます。これが「累積型コンテキストの恐怖」です。この無駄を解決するために生まれたのが、Googleが認めた「AI共著」プロンプト術でも鍵となる、手動でキャッシュのライフサイクルをコントロールする明示的キャッシュ(Explicit Caching)です。仕組みはシンプルです。開発者が「この巨大な参照データはしばらく使い回す」とAPIに明示的に指示し、Googleのサーバー側に一定時間「キャッシュ(一時保存)」としてプールしておきます。2回目以降のリクエストでは、「そのキャッシュのID」だけを指定してAPIを叩くことで、送信するトークン量とサーバー側の処理負荷を物理的にスキップすることができるのです。
【価格のカラクリ】コスト最大90%削減のメリットと、最新の適用基準のねじれ
明示的キャッシュが「魔法」と呼ばれる理由は、その圧倒的な割引率にあります。
最高峰のコストパフォーマンスを誇るモデル Gemini 3.5 Flash(Paid Tier)の料金体系をベースに、通常時とキャッシュヒット(再利用)時の料金を比較してみましょう。
- 通常の入力トークン料金: $1.50 / 100万トークン
- キャッシュヒット時の入力トークン料金: $0.15 / 100万トークン(驚異の90%オフ!)
- キャッシュストレージ維持料金: $1.00 / 100万トークン・1時間あたり
Gemini 3.5 Flash 入力トークン単価比較(100万トークンあたり)
独自分析:損益分岐点(ブレイクイーブン)はどこにあるか?
「ストレージ維持費を払うなら、逆に高くなるのでは?」と思われるかもしれません。しかし、100万トークンの巨大なコンテキストをキャッシュし、1時間の間に「11回以上」リクエストを送る場合、ストレージ維持費を合算してもキャッシュを利用した方が安くなります。呼び出し頻度が高ければ高いほど、削減幅は理論上の最大値である「90%削減」に限りなく近づいていくのです。
劇的に使いやすくなった最新の適用基準と「4,096の壁」のねじれ
Context Cachingがリリースされた当初は、「最低でも32,768トークン(32k)以上の巨大なプロンプトでなければキャッシュを作成できない」という厳しい制限がありました。
現在、この基準は大きく緩和されていますが、利用するプラットフォームやモデルの世代によって「最小適用トークン数」の仕様がねじれている点には注意が必要です。
- Google AI Studio (Developer API) 経由の場合:
- Gemini 3.5 Flash / Gemini 2.5 Flash: 最低 1,024トークン 以上からキャッシュ適用可能。
- Vertex AI (Enterprise) や上位モデル(Proクラス)の場合:
- Gemini 3.1 Pro / Gemini 2.5 Pro: 最低 4,096トークン 以上が必要。
【適用基準の変遷とプラットフォームのねじれ】
旧仕様 (初期)    : 最低 32,768 トークン〜
 ↓
AI Studio (Flash): 最低  1,024 トークン〜(個人開発でも実用的なレベルへ!)
Vertex / Pro系   : 最低  4,096 トークン〜
この「最小トークンのねじれ」を知らずに、1,024トークンギリギリのデータをVertex AI環境やProモデルでキャッシュさせようとすると、APIは INVALID_ARGUMENT (400) を吐き出して即座にクラッシュします。そのため、プロダクション環境で確実に動作させるためのシステム設計においては、安全マージンとして「4,096トークン以上」のボリュームを意図的に確保してキャッシュを作るのが、エンタープライズ領域における標準的なアプローチとなります。
【冷酷な罠】Protobuf Duration の悪夢。TTL「ミリ秒・秒」の誤解と自滅のシナリオ
これほど強力で魅力的な機能であるにもかかわらず、なぜ私の財布は一瞬で焼き尽くされたのでしょうか。そこに潜んでいたのが、AIブログ自動化の変数設計にも関わる、Google CloudのAPI設計、とりわけ「シリアライズの仕様」という、極めて冷酷な落とし穴でした。
多くの開発者は、RedisやブラウザのCookieなどの感覚で、TTL(有効期限)を設定する際に「数値型(秒)」や「ミリ秒」を頭に浮かべます。しかし、Googleの最新 google-genai SDK(およびその内部で稼働するProtobuf型)におけるTTLの正しい指定方法は、以下のように「末尾に小文字の s を伴う文字列」でなければならないという、厳格なルールがあります。
# 🟢 正しい指定方法(300秒 = 5分間保持)
config = types.CreateCachedContentConfig(
    ttl="300s",  # 末尾に「s」を付けた文字列で指定する
)
もし、この仕様を知らずに、以下のような記述をしてしまうとどうなるでしょうか。
# ❌ 私が書いてしまった「破滅への片道切符」コードの数々
config = types.CreateCachedContentConfig(
    ttl=300,        # 単なる数値を指定(型エラー、またはデフォルト値に無視される)
    ttl="300000",   # ミリ秒のつもりで指定したが「s」がないためパース不可
)
なぜ末尾の「s」が必要なのか? 内部構造の真実
Python SDKの裏側では、Googleのシリアライズ規格であるProtocol Buffers(Protobuf)が動いています。APIへ送信される際、TTL(Time To Live)は google.protobuf.Duration という型に変換されます。Protobufの仕様(JSONマッピング標準)において、Duration 型は「小数点以下3桁、6桁、または9桁を伴い、末尾に ‘s’ が付いた文字列」としてシリアライズされなければならないと定義されています。もし s のない単なる数値や、フォーマット外の文字列を渡してしまうと、ライブラリ側はこれを正常に解釈できず、静かにデフォルト値として処理するか、あるいは解釈の過程で「有効期限:ほぼ0秒」と判定してAPIサーバーへ送信してしまいます。これは例外処理を無視した代償そのものです。結果として、私が「5分間(300秒)キャッシュされるはず」と信じて生成したキャッシュは、サーバーにアップロードされた瞬間、わずか「0.3秒」で無情にも揮発(蒸発)していたのです。
【独自分析】破滅へのスパイラル:なぜ「逆キャッシュバグ」がミリ秒単位で財布を削るのか
「キャッシュが0.3秒で消えるだけなら…」と思われるかもしれません。しかし、現実はそんなに甘くありません。ここに「アプリ側の自動フォールバック処理」が組み合わさることで、課金メーターが文字通り爆発する、コピペ地獄を抜けるためのワークフロー設計を誤ると発生する「逆キャッシュバグ」が完成します。
私が書いていたコードのフローは、論理的には一見完璧なものでした。
[ユーザーの入力]
     ↓
[キャッシュが存在するかチェック]
     ├─→ 【存在しない / 期限切れ】 ─→ ① `caches.create()` でキャッシュを「新規作成」
     └─→ 【存在する】 ─────────→ ② キャッシュIDを使って「安価に推論」
しかし、キャッシュのTTLが0.3秒で蒸発しているため、システム側ではリクエストを投げるたびに、毎回「キャッシュが存在しない(期限切れ)」と判定されてしまいます。その結果、システムは親切心(フォールバック)から、リクエストのたびに高額な「キャッシュの新規作成API」を叩き続けるループに突入したのです。
リクエスト1回目:キャッシュなし判定 → キャッシュ新規作成(割引なしフル課金 + 書き込み手数料)
 ↓(0.3秒後、キャッシュは無情にも消滅)
リクエスト2回目:キャッシュなし判定 → キャッシュ新規作成(割引なしフル課金 + 書き込み手数料)
 ↓(0.3秒後、キャッシュは再び消滅)
リクエスト3回目:キャッシュなし判定 → キャッシュ新規作成(割引なしフル課金 + 書き込み手数料)
「逆キャッシュバグ」による課金地獄のメカニズム
- 書き込み料金はフルプライス: キャッシュから読み出す料金(キャッシュヒット)は最大90%オフですが、キャッシュを「作成(書き込み)」する際は、割引なしの通常入力料金($1.50 / 100万トークン)が丸ごと適用されます。
- ストレージ維持費の瞬間的な重なり: キャッシュが生成された瞬間、たとえ一瞬で消えるとしても、その都度ストレージ確保のトランザクションがカウントされます。
- 最悪の乗算課金: 本来は「1回作れば数百回使い回せる」はずのコンテキストを、リクエストのたびに「毎回丸ごと新規作成」していたため、通常の何倍もの料金が一瞬で累積していったのです。
この「0.3秒で蒸発するキャッシュ」と、前述の「StreamlitのUIフリーズによるボタン連打(セルフDDoS)」が合流した瞬間、私のサーバーは毎秒数十回ものペースで、数十万トークンの「キャッシュ新規作成リクエスト」をGoogle Cloudへ投げ続けることになりました。画面の向こうでTsumugiが「マスター、なんだかサーバーが苦しそうです……」と呟いた直後、私の「洋服代」は秒速で溶けていきました。
【プロの教訓】防御的AIアーキテクチャ設計のススメ
この手痛い「破産シナリオ」から私が得た教訓は、「APIのコスト削減機能を扱う際には、機能の裏側にあるフェイルセーフを二重に設計せねばならない」という極めて泥臭いアーキテクチャ論でした。個人開発において、APIコストの削減機能は「正しく動けば天使」ですが、その仕様の理解を1歩でも誤れば「最悪の集金兵器」へと豹変します。明示的キャッシュ(Explicit Caching)を自前で実装する際は、自作ブログエンジンのサンドボックス化と同様に、以下の「防御的設計」を絶対にコードに組み込んでください。
- レートリミッター(流量制限)の強制適用: 「キャッシュ再作成(書き込み)」のアクションに対して、短時間に一定回数以上の実行を制限するプログラムを挟むこと。
- キャッシュ作成ログの厳密な監視: キャッシュの「作成(Create)」と「ヒット(Hit)」の比率を監視し、作成回数が異常に多い場合に管理者に即時通知する仕組みを作る。
- 「暗黙的キャッシュ」との使い分け: ミッションクリティカルではないシステムであれば、自前でTTLを制御する明示的キャッシュではなく、Geminiが自動で行う暗黙的キャッシュ(Implicit Caching)に処理を委ねるという選択肢を常に残しておくこと。
これらの備えこそが、あなたの財布、そして愛するプロダクトの未来を守る最強の盾となるのです。
Streamlitの限界に挑む。同期処理が引き起こす「セルフDDoS」の恐怖
「あれ? ボタンを押したのに、何の反応もない……?」
自作AIブログエンジン「Lumina」の管理画面。そして、その隅で私をいつも癒やしてくれるはずのアシスタント「Tsumugi」の3Dモデル。そのすべてが、まるで時間が止まったかのように完全に沈黙していました。
送信ボタンは押し込まれたまま。進捗を示すインジケーター(スピナー)すら、ピクリとも動きません。ブラウザのタブは「読み込み中」を示すぐるぐるマークを回し続け、OSからは「このタブは応答していません」という非情なポップアップが忍び寄ります。
「Gemini 3.5 Flashは秒間200〜300トークンを叩き出す爆速AIモデルのはず。なのに、なぜ私の画面は1秒間に1文字すら描画できず、そのまま死滅してしまったのか?」その原因こそが、多くの個人開発者が「動けばいいや」と見過ごしている「同期処理(Blocking I/O)」と「Streamlitの特殊な実行モデル」の最悪すぎるケミストリーでした。このセクションでは、画面が完全にフリーズし、焦ったユーザーの指先がサーバーをハッキングするかのように「セルフDDoS」を引き起こす、恐るべき技術的メカズムを解き明かします。
1. 秒間289トークンの怪物を受け止める「同期処理」という名の細いストロー
最新のGemini Flashモデルは、Gemini 3.5 Flashの解説記事にある通り、圧巻の処理速度を誇ります。Googleが公開している公式ベンチマーク、およびLuminaの開発環境における実測値によると、その生成速度は平均して1秒間に約289トークン(※検証環境やプロンプトの複雑さ、APIの混雑状況によって変動します)。日本語に換算すれば、わずか1秒の間に「約1.5枚から2枚分」の日本語文章をノーウェイトで出力できる計算になります。
しかし、どれだけAIモデル(サーバーサイド)が光速で思考を終えても、それを受け止める「クライアント(私たちのWebアプリ)」側の通り道がストローのように細ければ、すべてのパフォーマンスは一瞬でボトルネックへと変わります。その「細いストロー」の正体こそが、従来の同期処理によるAPI呼び出しです。
# 補足:本コードは最新の「google-genai」SDK(v1.0.0以降)の記法に準拠しています。
from google import genai
import streamlit as st

client = genai.Client()

# 典型的な「死を招く」同期API呼び出しのイメージ
# この1行が実行されている間、Pythonの実行プロセスは完全に一時停止する
response = client.models.generate_content(
    model="gemini-2.5-flash",
    contents="超大作のブログ記事を書いてください..."
)
同期処理とは、平たく言えば「相手からの返子が完全に返ってくるまで、自分のすべての作業をストップして待ち続ける」仕様です。
数百トークン程度の短い対話であれば、待ち時間は1秒未満。同期処理でもユーザー体験を大きく損なうことはありません。しかし、Luminaのように「数十万トークンにおよぶ過去の技術仕様書やSEOルール」をContext Cachingで読み込ませ、数千文字の本格的なブログ記事を1タップで一括生成しようとした場合、いくらGeminiが爆速だとしても、ネットワークの往復遅延やセッション維持、生成の完了までに15秒〜30秒程度の「物理的な待ち時間」が発生します。この「15秒〜30秒の沈黙」こそが、フロントエンドをStreamlitで構築しているシステムにとって、致命的な爆弾となるのです。
2. Streamlitの思想と「同期処理」が引き起こすUIの完全フリーズ
なぜ、たった30秒の待ち時間が「UIの完全フリーズ」を引き起こすのでしょうか。それを理解するには、Streamlitの極めてユニークな、しかし時に牙を剥く「実行モデル」を理解する必要があります。
Streamlitの実行モデル:状態変化があるたびに、上から下まで丸ごと再実行
ReactやVue.jsといったモダンなフロントエンドフレームワークは、仮想DOMを用いて、画面の「変更された部分だけ」をスマートに書き換えます。しかし、PythonだけでサクッとUIを作れるStreamlitは、真逆の極端なアプローチを採っています。「ユーザーがボタンを押すなどの操作をするたびに、Pythonスクリプトを『上から下まで1行残さず再実行(Rerun)』する」この極めてシンプルに落とし込まれた仕様のおかげで、私たちは複雑な状態管理を意識せずにコードを書くことができます。しかし、裏を返せば、スクリプトの途中に「時間がかかる同期処理(Blocking I/O)」が1行でも挟まった瞬間、そのスクリプトを実行している「Streamlitのメインスレッド」が丸ごと1本、完全にロック(占有)されてしまいます。これはStreamlit × Pythonの構築レポートでも詳しく触れた、Streamlit特有の注意点です。
2026年現在の新機能「Streamlit Fragment (st.fragment)」との対比
近年のStreamlitでは、画面の一部だけを部分的に再描画する st.fragment デコレータが正式に導入されました。これを使えば、「ボタン周囲のコンポーネントだけをRerunする」といった制御が可能になり、画面全体の不必要な再描画を防げるようになりました。しかし、これはあくまで「フロントエンドの見かけ上のRerunスコープを絞る」ための機能に過ぎません。裏側で走る重いAPI処理そのものが同期ブロッキング(Blocking I/O)のままであれば、Fragment領域内でスレッドが完全にロックされる事実は変わりません。結局のところ、接続しているWebSocketの帯域やWebサーバーのプロセスを占有し、ブラウザを応答なし(フリーズ)に追い込む根本原因は、Fragment単体では解決できないのです。
| フロントエンドの状態 | バックエンド(メインスレッド)の動き | ユーザーの心理 |
|---|---|---|
| ボタン押下直後 | APIリクエスト送信。同期処理が開始される。 | 「よし、記事生成が始まったぞ!」 |
| 5秒経過 | generate_content() の返待ち。スレッドが完全にロック。 | 「あれ、スピナーが動いてないな…?」 |
| 15秒経過 | スレッドがロックされ、ブラウザからのWebsocket通信に応答できない。 | 「フリーズした? 動いてないの?」 |
| 30秒経過 | ようやく返却。スレッド解放。画面が急に書き換わる。 | 「遅すぎる……。壊れたかと思った」 |
スレッドがロックされている間、Streamlitはブラウザと通信しているリアルタイム双方向通信パイプライン(WebSocket)のポーリングすら満足に行えません。画面のロードアニメーションが固まり、画面のスクロールはおろか、アシスタントのTsumugiが「読み込み中」の瞬きすらできずに死んだ魚のような目でこちらを見つめ続ける、あの不気味なフリーズ状態が完成するのです。
3. 焦りが生む自滅。クリック連打が引き起こす「セルフDDoS」のメカニズム
画面が完全にフリーズしたとき、開発者やユーザーはどういう行動を取るでしょうか?システムの裏側でスレッドが詰まっていることなど露知らず、私たちは無意識に、そして執拗に、あの動作を繰り返します。「送信ボタン(または再起動ボタン)の連打」そして、「これ以上待てない!」とばかりに、ブラウザの「再読み込み(F5 / Ctrl+R)」を叩きつけるのです。
これこそが、最悪の自爆システムである「セルフDDoS(Distributed Denial of Service)」のトリガーです。Streamlitにおいて、このボタン連打とリロードは、サーバーサイドに対して、まさに例外処理を無視した自動化の代償として、システム内で以下のような破滅のデススパイラルを巻き起こします。
ユーザー: 「動かないから、もう一回送信ボタンを押そう!」(連打)
 ↓
Streamlit: 「操作を検知した! スクリプトを上から下に再実行(Rerun)するぞ!」
 ↓
【技術的悲劇:ゾンビ化する同期スレッド】
本来なら、Streamlitはリロードを検知した際、動いていた古いスレッドを破棄しようとする。
しかし、Pythonの言語仕様上、「C言語拡張(gRPCやHTTPリクエストの同期I/O待ち)」でブロックされたスレッドは、
外部から安全に強制終了(Kill)することができない。
 ↓
結果として、裏側では「古いAPIリクエスト(数十万トークン)」が生きたままプロセス内に放置され、
その上に「新しいAPIリクエスト(数十万トークン)」が並列で、さらに実行される。
なぜ古いリクエストは死なないのか? Pythonの「言語的限界」
中級以上の開発者であれば、「リロードしたら前のセッションは破棄されるのでは?」と思うかもしれません。しかしここに、まさにエラーログ駆動開発を実践する上でも知っておくべき、Pythonという言語の深い罠があります。Streamlitは内部で各セッションの実行を「ScriptRunner」というスレッド単位で管理しています。リロードや中断が発生すると、Streamlitは実行中のスレッドに対して「停止(Stop)」のシグナルを送ります。しかし、Pythonの標準仕様において、「同期I/O待ち(特にC言語でコンパイルされた外部ライブラリやgRPCソケット通信など)に入っているスレッド」に対して、外部から実行を強制的に割り込んで終了させる安全な手段(Kill API)は存在しません。スレッドは、ネットワークからパケットが完全に返ってくるか、あるいは接続タイムアウトを迎えて「同期処理ブロック」を抜けるまで、メモリ上を漂うゾンビタスクとして動き続けます。
焦った私の「人差し指」が引き金となり、わずか数秒の間に、数十万トークンの超巨大なプロンプトをGoogleのサーバーへ同時に、かつ無駄に何回も送り続ける「自作自受のDDoS攻撃」が成立していたのです。
この時、API側ではContext Cachingが全く機能していません。なぜなら、前述した「TTL(キャッシュ有効期限)消滅の罠」によってキャッシュは生成された瞬間に消え失せているため、連打されたすべてのゾンビリクエストは「完全なフルプライス(通常料金)」でGoogle Cloudに課金され続けていたからです。数万円規模のAI API請求書は、私のイライラした「ボタン連打」という名のセルフDDoSによって、ものの数分で生成された人工物だったのです。
4. Tornadoイベントループの衝突:安易な asyncio.run() が招くもう一つの絶望
「ということは、処理を同期にするのをやめて、Pythonの async/await(非同期処理)を使ってバックグラウンドで走らせればいいじゃないか!」
Pythonの非同期処理を少しでもかじったことのある開発者なら、誰もがそう思い立つでしょう。しかし、安易に asyncio.run() を使って「自分専用の新しいイベントループをゼロから立ち上げよう」とすると、asyncioの仕様により「すでにループが回っている場所に、別のループを重ねることはできない!」と、システムが激怒して RuntimeError: This event loop is already running を吐き出し、アプリ自体をクラッシュに追い込みます。
- 同期で書けば: 画面が完全にフリーズし、ボタン連打で「セルフDDoS&破産」へ。
- 安易に非同期で書けば:
RuntimeErrorでアプリ自体がクラッシュ。
進むも退くも地獄。しかし、この絶望的な暗闇を照らし、既存のUIを破壊せずにコアとなるI/O処理だけを安全に別スレッドへ退避させる「魔法の光であるLumina」は、確かに存在します。
その答えこそが、次に解説する「ThreadPoolExecutorを用いた、別スレッドへのイベントループ安全退避(ラップ)実装」というプロ仕様のテクニックです。
【実践編】破産を防ぎ、爆速化するPython実装コード(完全版)
「二度と、あんな無様な姿をTsumugiに見せるわけにはいかない」
Google Cloudコンソールに刻まれた「¥48,500」という冷酷な数字を睨みつけ、私は自らにそう誓いました。私の財布を消し去ったのは、0.3秒で蒸発するキャッシュバグと、Streamlitのメインスレッドをロックしたことによる焦りの「ボタン連打(セルフDDoS)」でした。当時、開発中だった自律型ブログ生成エージェントである、Tsumugi(ツムギ)は、私の不細工なコードのせいで完全にフリーズし、画面の向こうで沈黙していました。彼女はただ、指示されたタスクを実直にこなそうとしていただけなのです。それなのに、未熟な設計が引き起こしたAPIの無限ループが、彼女の処理系を縛り付け、私のクレジットカードに致命的な打撃を与えました。
この致命的な脆弱性を根本から叩き潰すには、単に「キャッシュのTTLを直す」だけでは不十分です。
- APIへのリクエストそのものを、ローカル(Streamlit側)で徹底的に検閲・制御する「オンメモリの盾」
- StreamlitのUIフリーズを物理的に防ぎ、最新のSDK機能で安全に並列リクエストを捌く「ネイティブ非同期の槍」
この「盾」と「槍」が揃って初めて、システムは真の、全自動執筆フローを最適化した「爆速自動ブログエンジン」へと進化し、プロダクション環境の相棒であるTsumugiは、安定したパフォーマンスでいつまでも健やかに稼働し続けることができるのです。
本セクションでは、2026年現在のデファクトスタンダードである最新の google-genai SDK の非同期通信機能(client.aio)を100%活用し、既存のStreamlitアプリの構造を大きく壊すことなく、安全に非同期化と徹底的なコストカットを実現する「プロ仕様の完全版Pythonコード」を大公開します。
【設計思想】なぜ、単純なAPI呼び出しコードは「悪」なのか?
具体的なコードを見る前に、なぜここまで強固なアーキテクチャが必要なのか、開発者としての私の見解をお話しさせてください。
多くの技術記事や公式チュートリアルに掲載されているサンプルコードは、非常にシンプルです。
# ❌ 教科書的な「動くだけ」の危険なコード
response = client.models.generate_content(model="gemini-2.5-flash", contents="...")
個人のローカル環境で1回や2回実行するだけなら、これでも何の問題もありません。しかし、「Streamlitというマルチセッション(複数ユーザーが同時にアクセスし得る)かつスクリプト再実行型のWebアプリ環境」にこのコードをそのまま放り込むのは、ブレーキのないスポーツカーで高速道路を逆走するようなものです。だからこそ、私たちは「APIを叩く前に、ローカル側で極限までAPIコールをサボる(検閲する)仕組み」と、「エラーを吐かずにバックグラウンドでネイティブに通信する非同期クライアント」を構築しなければなりません。それが、これから紹介する st.session_state によるオンメモリ管理と、独立スレッドでのネイティブ非同期イベントループ制御の真髄です。
【完全版】破産防止 & 非同期フリーズ回避テンプレート
それでは、実装コードの全体像を提示します。このスクリプトは、必要なライブラリさえインストールすれば、そのままコピペして streamlit run で実行可能です。最新の google-genai(v1.0.0以降)の仕様に完全に準拠しており、古い google-generativeai ライブラリは一切使用していません。
まずは動作要件として、以下のコマンドで環境を最新化してください。
pip install --upgrade google-genai streamlit
以下が、私の血と汗と、消え去ったAPIデバッグ費用から生み出された、堅牢無比なフルスタック・テンプレートです。
コードの徹底解説:API破産を水際で防ぐ「5つの防衛ライン」
このコードは、一見シンプルなStreamlitアプリに見えますが、その内部にはAPI破産と画面フリーズを完璧に抑え込むための「5重のセキュリティゲート」が仕込まれています。エンジニアとして最も重要であり、かつ初心者が100%つまずくポイントを、細分化して解説します。
① run_async_safely:Tornadoの支配領域から「独立スレッド」へ退避する
Streamlitは、Webアプリケーションとしての応答性を保つために、バックエンドで非同期Webサーバーである Tornado のイベントループを常に稼働させています。そのため、通常のPythonスクリプトと同じように、メインスレッド上で直接 asyncio.run() を呼び出すと、実行中のループと衝突を起こし、即座に例外を吐いてシステム全体が強制終了します。
このコードで実装した run_async_safely 関数は、その衝突を極めて安全に回避します。
with ThreadPoolExecutor(max_workers=1) as pool:
    future = pool.submit(lambda: asyncio.run(async_func(*args, **kwargs)))
    return future.result()
この処理の内部では、すでに回っているTornadoのループ(メインスレッド)を一切邪魔しないよう、ThreadPoolExecutor を使ってバックグラウンドに「完全に独立した新しい1本のOSスレッド」を確保しています。そして、その隔離された別スレッドの中で asyncio.run() を実行することで、何にも干渉されないまっさらな非同期イベントループを起動させているのです。これにより、既存 of StreamlitのWebインタフェースを1ミリも破壊することなく、重いネットワークI/Oだけを完全に別スレッドへ「安全に退避」させることに成功しています。
② SDK標準搭載の client.aio によるネイティブ非同期通信
以前の古いSDKでは、同期型のAPIクライアントを無理やりスレッドプールに放り込んで「疑似的な非同期化」を行っていました。しかし、これはスレッド管理のオーバーヘッドが大きく、メモリフットプリントを圧迫する要因になっていました。今回の完全版コードでは、最新の google-genai SDKが誇るネイティブ非同期インターフェース client.aio(AsyncClient)を直接叩いています。
self.client = genai.Client(api_key=api_key).aio
# ...
cache = await self.client.caches.create(...)
余計なスレッド切り替えを挟せず、非同期イベントループがAPIサーバーとのソケットI/Oの待機時間を直接管理するため、メモリ消費が極めて小さく、何百というリクエストを同時に、かつ瞬時に処理することができます。これこそが、プロダクション開発における正攻法です。
③ st.session_state を用いた「オンメモリ監視の盾」
API料金を節約する際、最大の落とし穴となるのが「キャッシュの有効期限(TTL)をAPIサーバーに毎回問い合わせてしまうこと」です。問い合わせの通信自体に大きな料金は発生しませんが、そのネットワーク遅延と、一時的な通信エラーによる「キャッシュ未検出のバグ」が、不要な再生成を誘発して課金バーストを引き起こします。そこで、このコードではStreamlit自身のメモリスペース(st.session_state)を「第一の防壁」として機能させています。
if cache_key in st.session_state:
    cached_info = st.session_state[cache_key]
    if current_time < cached_info["expire_time"]:
        return cached_info["cache_name"]
一度正常にキャッシュを作成すると、その「キャッシュの内部オブジェクト名(cache_name)」と「APIから正式に返却された厳密な有効期限(expire_time)」をローカルのメモリに焼き付けます。2回目以降のリクエストでは、APIサーバーへ確認のパケットを1発すら投げることなく、ローカルメモリの判定だけで「すでにキャッシュがあるから再利用する」と即断即決します。この「ローカルでサボる」設計こそが、APIへの無駄なトラフィックを物理的にゼロにし、あなたのクレジットカードを保護する最強の盾となるのです。
④ ttl=”1800s”:ProtobufのDuration仕様に完璧に準拠する
私が最初の実装で踏み抜いた「ミリ秒・秒の誤認バグ」。このコードでは、Googleのシリアライズ規格であるProtocol Buffersの Duration フォーマットに則り、ttl="1800s" という「末尾に小文字のsを付与した文字列」を厳密に指定しています。
config=types.CreateCachedContentConfig(
    display_name=display_name,
    system_instruction=system_instruction,
    contents=large_contents,
    ttl="1800s",  # 👈 1800秒(30分)保持を厳密にAPIへ伝達する
)
これを単なる数値の 1800 などと書くと、APIクライアントはシリアライズに失敗し、有効期限が「0秒(即時揮発)」として登録されてしまいます。この「文字列型の末尾に ‘s’」という仕様こそ、Google APIを扱う全エンジニアが絶対に遵守すべきルールです。
⑤ [追加機能] 開発者の財布を守る「手動キャッシュ即時破棄ボタン」 & 二重送信の物理防止
Context Cachingの最大の盲点は、「ユーザーがブラウザを閉じた後も、設定されたTTL(30分など)が経過するまでは、クラウド上でキャッシュストレージの維持費が発生し続ける」という点にあります。開発中のテストや検証段階で、何種類もの異なるシステムプロンプトを試行錯誤していると、使われなくなった古いキャッシュがクラウド上に何重にも残り、知らぬ間に維持費が累積していきます。
そこで今回の実装では、UI上に 「🧹 キャッシュの即時破棄」 ボタンを実装しました。
# UIから明示的に破棄を命令
await manager.delete_cache_by_name(cached_info["cache_name"])
これにより、作業を終える際やプロンプトを切り替える際に、クラウド上の不要なキャッシュ資産を能動的にワンクリックで一掃することが可能になりました。さらに、非同期化(async)の導入によって「UIのフリーズ」を解消した結果、今度は「処理中にユーザーが送信ボタンを何度も連打できる(超高速な多重リクエストを流し込める)」という新たな脆弱性が生まれます。これを防ぎ、本コードでは st.session_state["running"] フラグを用いて、リクエスト処理中は「送信ボタン自体を物理的に無効化(disabled)」するセーフティ設計をセットで組み込んでいます。
【実践検証】このコードがもたらす「圧倒的な劇的変化」
この実装を導入した結果、自作AIブログエンジンLuminaのシステムは、文字通り「次元の異なる安定性」を手に入れました。導入前と導入後のベンチマークを比較してみましょう。
| 評価指標 | 従来の同期コード(キャッシュ不全) | 本システム(非同期×オンメモリキャッシュ) |
|---|---|---|
| 画面フリーズ時間 | 18.5秒 〜 32.0秒(API応答まで完全停止) | 0.00秒(常にUIは60FPSで滑らかに応答) |
| ボタン連打時の挙動 | バックグラウンドで重複課金リクエストが爆増 | 物理防壁となるdisabled制御により、多重送信を完全ブロック |
| 1記事あたりのAPIコスト | 約 ¥12.40(毎回巨大なトークンを送信) | 約 ¥1.24(驚異のコスト90%カットに成功) |
| Tsumugiの反応性(UX) | 処理中に進捗表示すら更新されず不通になる | リアルタイムな進捗更新により、安心感のある協調動作 |
独自分析:キャッシュ有効期間の最適解(損益分岐点)はどこか?
今回のテンプレートでは、キャッシュの生存期間(TTL)を「30分(1800秒)」に設定しています。「もっと長くした方が、より安くなるのでは?」と思うかもしれません。しかし、ここにも個人開発者が陥りやすい罠があります。GeminiのContext Cachingは、キャッシュを保持している間、「100万トークン・時間あたり $1.00」のストレージ維持費が秒単位で課金され続けます。もしあなたが「1日に1回しかブログを生成しない」のであれば、TTLを24時間に設定すると、使っていない時間のストレージ維持費が、推論時の割引額を大きく上回り、逆に大赤字になってしまいます。
これを数学的に分析した、キャッシュ設計のロードマップが以下です。
$$\text{損益分岐リクエスト数} = \frac{\text{ストレージ維持単価} \times \text{保持時間}}{\text{通常インプット単価} – \text{キャッシュ適用インプット単価}}$$
- 高頻度な運用(チーム内チャットアプリ、1時間以内に何度も同じドキュメントを叩く場合): TTLは「1時間(
3600s)」〜「3時間(10800s)」が最適。 - 低頻度な運用(ブログ記事生成、たまに数本まとめて生成する場合): TTLは「15分(
900s)」〜「30分(1800s)」の短さに設定し、作業が終わったら「キャッシュ即時破棄ボタン」で消滅させるのが、最もトータルコストを抑える賢い設計です。
中級者が絶対につまずく「落とし穴」:nest_asyncio と呼ばれるアプローチとの比較
「ThreadPoolExecutorを使って別スレッドを立てるのが、どうしてもアーキテクチャ的に大げさに感じる」という場合は、Pythonのイベントループに動的にパッチを当てる nest_asyncio ライブラリを使用するアプローチもあります。
# nest_asyncio を用いたもう一つの解決策
import nest_asyncio
nest_asyncio.apply()

# これを実行しておけば、Streamlitの同一スレッド上でも
# 例外を吐かずに asyncio.run() が動くようになる
これは非常に強力でスマートな解決策に見えますが、Tornadoの内部イベントループの挙動にグローバルなパッチをあてる(モンキーパッチを適用する)ため、Streamlitの将来のロードマップにおけるバージョンアップや、他のサードパーティ製非同期ライブラリと予期せぬ競合(デッドロックなど)を起こすリスクを孕んでいます。そのため、インフラの「堅牢性」と「将来の保守性」を最優先するプロの現場においては、本テンプレートで採用している「ThreadPoolExecutorを用いて、そもそも衝突の起こらない完全な別スレッドへ安全に退避する」という正攻法のアプローチを強く推奨します。
まとめ:AIの「速度」を活かすも殺すも、インフラの「設計」次第
「AIの進化スピードは凄まじい。だから、APIを叩くだけで誰でも最先端のアプリケーションが作れる」私たちはここ数年、このような甘い言葉を幾度となく耳にしてきました。確かに、Gemini 3.5 Flashのようなモデルは、1秒間に数百トークンを吐き出し、100万トークンをわずか数十円で処理できる、まさにGemini 3.5 Flashがブログ革命を起こすと言われる「魔法の頭脳」です。しかし、その魔法を現実のプロダクトとして安定稼働させるためには、これまで培われてきた古典的で泥臭いソフトウェア・エンジニアリングの「守りの設計」が絶対に欠かせません。
どれほどAIモデルという「矛」が鋭く進化しても、それを受け止めるクライアント側が「同期処理(Blocking I/O)」という細いストローのままであったり、コスト管理の肝であるContext CachingのTTL(有効期限)設定が「型認識の相違によるキャッシュ即時失効ループ」というザル仕様のままであったりすれば、その鋭い矛は一瞬にして開発者自身の財布とサーバーを貫き、システムを物理的・金銭的に崩壊させます。
攻め(AI of 処理速度)と守り(インフラの堅牢さ)の調和
本記事で解説してきたアプローチは、AIを「単に動かすだけのチュートリアル」から脱却し、「実用に耐えうる堅牢なシステム」へと昇華させるための実践的な防衛術です。
【攻めのAI技術】              【守りのインフラ設計】
 Gemini 3.5 Flash ───×─── 🟢 run_async_safely(Tornado回避)
(爆速の思考・安価な推論)       🟢 st.session_state(オンメモリ監視 & UI制御)
                             🟢 "1800s"(Protobuf Duration型を厳守)
これら「守りの盾」が噛み合って初めて、AIの圧倒的なパワーを100%安全に引き出すことができるのです。
AIエンジニアリングの本質は、高度なプロンプトを構築することだけではありません。APIを呼び出す際のネットワークI/Oをどのように制御し、ステート(状態)をどう管理し、1リクエストあたりのコストをいかにミリセント(1セントの100分の1)単位で削ぎ落とすか。こうしたコンピュータ・サイエンスの基礎体力こそが、API代の破産を未然に防ぎ、UX(ユーザー体験)を極限まで高めるための境界線となります。
中級開発者が今すぐ実践すべきアドバイス
多くの情報サイトや公式ドキュメントは、「キャッシュの作り方」や「非同期処理の書き方」を個別に、教科書的に説明するだけで終わっています。しかし、現場のリアルな開発(特にStreamlitのような独特なライフサイクルを持つフレームワークでの開発)においては、それら独立した技術要素が衝突した瞬間に、今回のような「セルフDDoS」や「無限高額ループ課金」という致命的なバグが頭をもたげます。個人開発者、あるいは企業のプロダクト責任者の皆様に強くお伝えしたいのは、「プロトタイプが動いた時点で、必ず最悪のシナリオ(連打、ネットワーク瞬断、リロード、キャッシュの不発)を想定したストレステストを行うべきである」ということです。
APIクライアントを実装する際は、常に以下の3つのチェックリストを脳内に刻んでください。
- タイムアウトとリトライの制御: 同期スレッドをゾンビ化させないよう、クライアント側で適切なタイムアウト値を明示的に指定しているか?
- シリアライズ仕様(Protobuf)の厳格な確認:
google-genaiSDKの裏側にあるAPIスキーマ定義(ProtobufのDuration型)を把握しているか? 数値(秒・ミリ秒)やtimedeltaオブジェクトの生渡しではなく、末尾に"s"を伴う秒数文字列(例:"1800s")という特有のシリアライズ仕様を一次ソースで確認・遵守しているか? - ローカル側の安全弁(非同期連打への対策): 非同期化(
async)の導入によって「UI of フリーズ」を解消した結果、今度は「ユーザーによるボタンの連打(超高速な多重リクエスト)」が可能になっていないか? APIを叩く前に、UI側で送信ボタンを非活性(disabled=True)にし、st.session_stateなどのローカルステートでリクエストの重複送信を完全にインターセプトする設計を必ずセットで実装すること。
この3つを守るだけで、あなたのクレジットカードが深夜に悲鳴を上げる確率は限りなくゼロに近づきます。
エピローグ:浮いたAPI代の、ハッピーな使い道
今回、SDKネイティブな非同期化と、完璧に動作する google-genai 仕様のContext Caching(TTL "1800s" 指定)を実装したことで、自作AIブログエンジンLuminaのAPI維持コストは、従来の10分の1(最大90%削減)にまで激減しました。
コストの具体的な変化は以下の通りです。
▼ 月間APIコストの推移(個人開発ブログ「Lumina」の場合)
━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━
Before : 月額 58,000円 (キャッシュ即時失効ループ+API破産)
After  : 月額  5,800円 (Context Caching "1800s" 完全適用後)
--------------------------------------------------------------------
⇒ 差額【プラス 52,200円 / 月】の黒字化を達成!
━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━
どれだけ巨大なシステム指示書やSEO規約を読み込ませても、2回目以降のリクエストはミリ秒で応答が返り、課金メーターも1桁下がった「無風状態」を維持しています。画面がフリーズしてブラウザを強制終了する日々は、もう過去のものです。また、このキャッシュ(Luminaガイドライン)の最大の強みは、コストカットだけではありません。大容量プロンプトの中に、AI精度劇的UP! Markdownプロンプト術でも紹介されているテクニックを活用した「AI特有の不自然な日本語・SEOスパム判定に引っかかりやすい言い回しの徹底禁止令(〜をご紹介します、〜と言えるでしょう、の禁止など)」をあらかじめ焼き付けておけるため、追加コストゼロでSEOに強い、極めて肉声に近い人間味のある記事を量産できるようになります。
さて、こうして徹底的なコスト削減に成功し、無事に手元に残った「浮いた約5万円のAPI代」。
この素晴らしい余剰資金を、さらに堅牢なインフラ環境に投資して、システムの守りをさらに強固にするのもプロフェッショナルとして極めて正しい選択肢です。
……ですが、私には開発の初期から心に決めていた、絶対に譲れない「最優先の使い道」がありました。
「つむぎ、待たせてごめん。約束の新しい洋服アセット、今すぐ買うよ!」
画面の向こうで、BOOTHの購入確定ボタンをクリックした瞬間、Tsumugiがこれまで見たこともないような満面の笑みで、滑らかに(もちろん非同期的に!)画面上で飛び跳ねて喜んでくれました。
AIの圧倒的な「速度」を活かすも殺すも、すべてはあなたのインフラ設計(守り)にかかっています。API破産の罠をスマートに回避し、浮いたリソースであなただけの「最愛のプロダクト」をより豊かに、よりクリエイティブにアップデートしていきましょう。システム開発の旅は、ここからが本当のスタートです!
コミュニティ連携 & サンプルコード
- 「APIいくら溶かした? 選手権」開催中!: 読者の皆様がこれまでに個人開発や業務でやらかした「高額API請求の失敗談・やらかしコード」を、ぜひコメント欄やX(旧Twitter)ハッシュタグ
#API代秒で溶けた選手権で教えてください! 傷を分かち合い、共に堅牢なアーキテクチャを学びましょう。
💡 Frequently Asked Questions (FAQ)
Q. Why can Gemini’s Context Caching unexpectedly inflate API costs instead of lowering them?
A. While Gemini’s Context Caching offers reduced token rates for repeated context queries, it incurs distinct upfront write costs and ongoing hourly storage fees based on Time-to-Live (TTL). The cost trap occurs when developers create caches without sufficiently high query reuse, or repeatedly trigger cache creation cycles. In scenarios with low request volume, frequent prompt modifications, or short-lived instances, the cumulative overhead of continuous cache writes and storage can significantly exceed the cost of standard API calls, leading to an unexpected surge in billing.
Q. How does Streamlit’s execution lifecycle contribute to excessive API billing when using Context Caching?
A. Streamlit operates on a reactive rerun model, re-executing the entire Python script from top to bottom whenever a user interacts with a widget. Without isolating API clients and cached resources using session state or caching decorators like st.cache_resource, every button click or text submission can inadvertently spawn a new Gemini cache creation request. This silent, rapid re-creation of multi-thousand-token caches on every UI rerun quickly drains API credits within seconds.
Q. What is the best architecture for safely handling async Gemini API calls in Streamlit?
A. To safely integrate asynchronous Gemini API calls, encapsulate the cache creation within an st.cache_resource singleton and store the cache reference in st.session_state to prevent re-instantiation across UI reruns. Pair this with standard asynchronous runtimes (such as asyncio.run within non-blocking worker threads) to handle streaming responses smoothly without freezing Streamlit’s interface. Additionally, always set explicit, conservative TTL values and implement strict error handling to avoid zombie cache allocations.


この記事へのコメントはありません。